LiteLLM으로 AI Gateway 구축과 운영
목표
- AI Gateway를 로컬에서 직접 구축하고 라우팅·캐싱·비용·관측까지 한 스택에서 실측한다
- LiteLLM Proxy 뒤에 Ollama 로컬 모델 2개를 붙여서 진행한다
- 통합 API 호출, virtual key와 rate limit, 로드밸런싱과 폴백, 캐시 히트, 예산 차단, 프로메테우스·OTEL 관측을 응답 헤더와 컨테이너 로그로 확인한다
구성
- LiteLLM Proxy: AI Gateway 본체, OpenAI 호환 엔드포인트 제공
- Ollama: 백엔드 LLM 서버 (llama3.2:1b, qwen2.5:0.5b 두 모델을 별도 프로바이더처럼 등록)
- PostgreSQL: virtual key 관리용 DB
- Redis: 완전 일치 요청을 해시로 캐싱하는 캐시 백엔드
- macOS의 Docker는 Metal GPU를 쓰지 못해 CPU 추론으로 동작하지만 게이트웨이 데모에는 충분하다
Warning
💡 네이티브 Ollama 설치 시 api_base를 host.docker.internal로 연결한다
게이트웨이 구축
-
작업 디렉터리를 생성하고 docker compose 파일을 작성한다. redis 서비스를 처음부터 함께 올려 캐싱까지 한 번에 준비한다
-
게이트웨이 설정 파일을 작성한다. 모델 별칭과 폴백 체인이 핵심이다
-
스택을 기동하고 백엔드 모델 2개를 다운로드한다
-
게이트웨이가 살아있는지, 모델이 등록됐는지 확인한다
통합 API 호출
-
OpenAI 호환 API로 호출한다. 백엔드가 Ollama여도 앱 입장에서는 OpenAI SDK 그대로다
-
model 값만 바꾸면 다른 백엔드로 라우팅된다. 앱 코드 변경 없이 모델 교체가 되는 것이 통합 API의 핵심이다
Virtual Key와 Rate Limit
-
마스터 키로 팀용 virtual key를 발급한다. 실제 백엔드 키는 게이트웨이만 알고, 앱에는 이 키만 배포한다
curl -s http://localhost:4000/key/generate \ -H "Authorization: Bearer sk-dotoryeee-1234" \ -H "Content-Type: application/json" \ -d '{"key_alias":"dotoryeee-key","models":["llama-small","qwen-small"],"rpm_limit":2}' { "key": "sk-2TLJ91iCDREGN_0mDJFFeA", "key_alias": "dotoryeee-key", "models": ["llama-small", "qwen-small"], "rpm_limit": 2 } -
발급한 키를 Authorization 헤더에 넣고 연속 3회 호출하면 rpm_limit 2를 초과한 세 번째 요청이 차단된다
curl -s http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer sk-2TLJ91iCDREGN_0mDJFFeA" \
  -H "Content-Type: application/json" \
  -d '{"model":"qwen-small","messages":[{"role":"user","content":"hi"}],"max_tokens":5}'    #동일 요청 3회 반복

call 1 -> HTTP:200
call 2 -> HTTP:200
call 3 -> HTTP:429
  에러: Rate limit exceeded for api_key: ebd5686b... Limit type: requests.
로드밸런싱과 라우팅 전략
지금까지는 별칭 하나에 백엔드 하나를 붙인 형태다. 로드밸런싱은 같은 별칭에 여러 배포(Deployment)를 등록해 하나의 모델 그룹(Model Group)으로 묶는 방식이다.
-
기존 model_list에 chat-small 그룹을 추가한다. model_name이 같은 항목 두 개가 한 그룹이 된다
litellm_config.yamlmodel_list: - model_name: chat-small # 같은 별칭 = 하나의 모델 그룹 litellm_params: model: ollama/llama3.2:1b api_base: http://ollama:11434 - model_name: chat-small litellm_params: model: ollama/qwen2.5:0.5b api_base: http://ollama:11434 router_settings: routing_strategy: simple-shuffle # 기본값, 가중치 기반 무작위 분산 -
게이트웨이를 재시작하고 chat-small로 10회 호출하면서 x-litellm-model-name 헤더로 어느 백엔드가 처리했는지 확인한다
docker compose restart litellm

for i in $(seq 1 10); do
  curl -s -D - -o /dev/null http://localhost:4000/v1/chat/completions \
    -H "Authorization: Bearer sk-dotoryeee-1234" -H "Content-Type: application/json" \
    -d '{"model":"chat-small","messages":[{"role":"user","content":"hi"}],"max_tokens":1}' \
    | grep -i x-litellm-model-name
done

x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/qwen2.5:0.5b
x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/qwen2.5:0.5b
x-litellm-model-name: ollama/llama3.2:1b
x-litellm-model-name: ollama/qwen2.5:0.5b
x-litellm-model-name: ollama/llama3.2:1b
요청 model은 계속 chat-small 하나인데 llama 7회, qwen 3회로 두 백엔드에 나뉘어 처리됐다.
-
응답 헤더 전체를 보면 실제 처리한 배포의 id·모델·api_base와 소속 그룹이 함께 내려온다
-
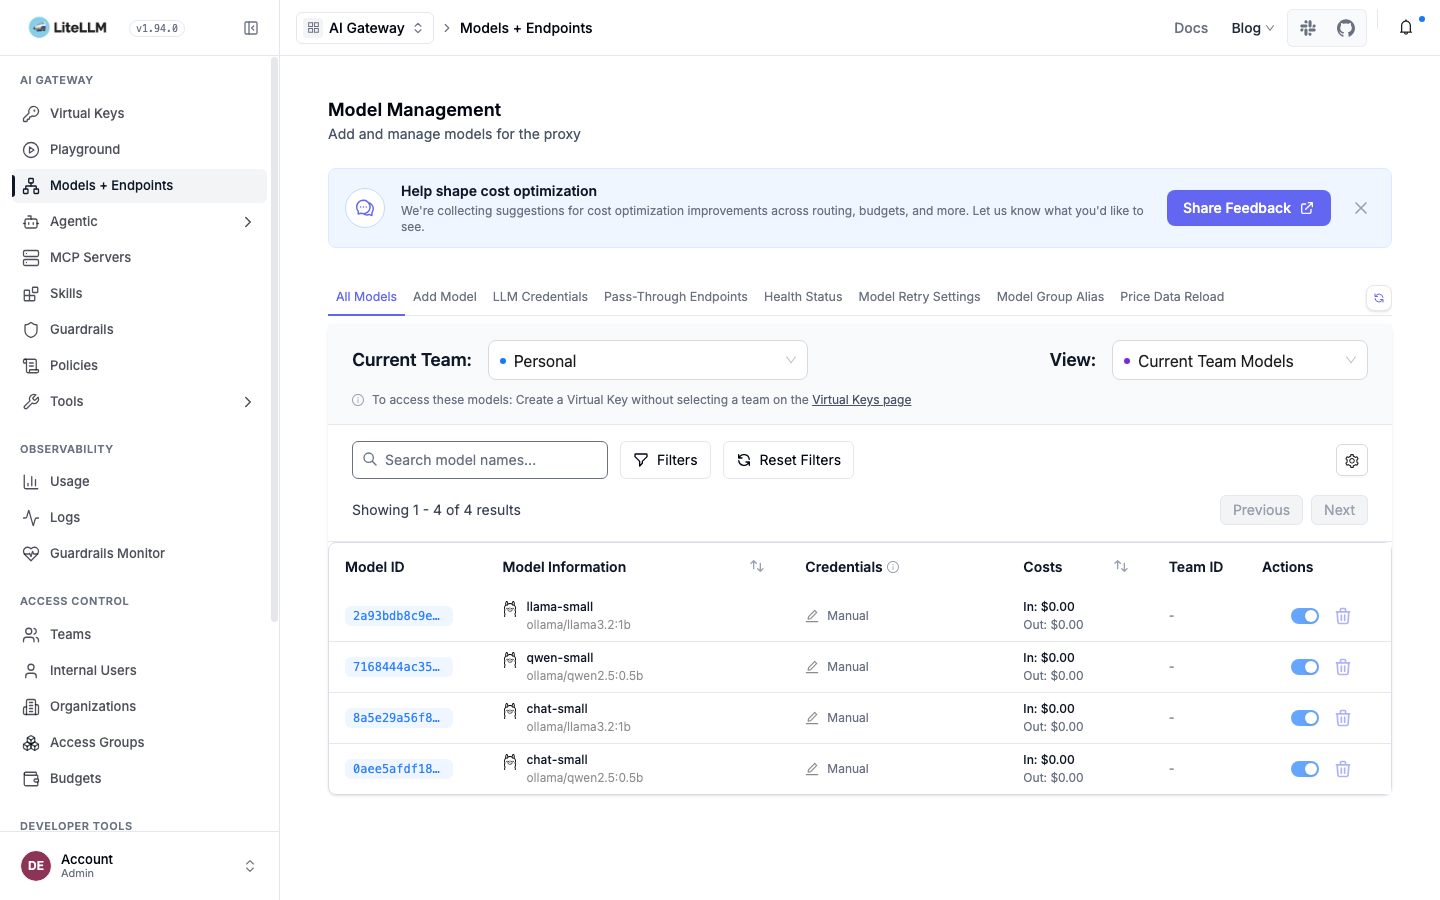
Admin UI의 Models 메뉴에서도 chat-small 그룹에 배포 두 개가 붙은 것이 보인다
Notice
💡 두 배포가 같은 api_base라 분산은 x-litellm-model-name으로 구분한다
가중치와 지연 라우팅
-
특정 배포로 트래픽을 더 몰고 싶으면 weight를 지정한다. qwen에 3, llama에 1을 주면 qwen이 3배 자주 선택된다
-
재시작 후 20회 호출하면 지정한 1:3 비율에 맞게 갈린다
-
routing_strategy를 latency-based-routing으로 바꾸면 최근 응답이 빠른 배포를 우선한다. 0.5b인 qwen이 1b인 llama보다 빨라 트래픽이 qwen으로 쏠린다
-
워밍업 호출로 지연 표본을 쌓은 뒤 12회 호출한 집계다
simple-shuffle의 절반씩 분산과 달리 요청 대부분이 빠른 qwen으로 갔다. 전략 한 줄로 분산 기준이 무작위에서 지연 기반으로 바뀐다.
재시도와 타임아웃
배포가 실패하거나 느릴 때 게이트웨이가 어떻게 버티는지 정하는 값들이다.
-
router_settings에 재시도·타임아웃·쿨다운을 함께 둔다
-
타임아웃을 확인하려고 timeout을 1로 낮추고 qwen-small에 긴 답변을 요청하면 1초에서 잘린다
curl -s http://localhost:4000/v1/chat/completions \ -H "Authorization: Bearer sk-dotoryeee-1234" -H "Content-Type: application/json" \ -d '{"model":"qwen-small","messages":[{"role":"user","content":"Write a long essay."}],"max_tokens":300}' {"error":{"message":"litellm.APIConnectionError: OllamaException - litellm.Timeout: Connection timed out. Timeout passed=1.0, time taken=1.001 seconds. ..."}} -
num_retries는 로그로 확인한다. 고장난 백엔드로 요청하면 지정한 횟수만큼 재시도한 기록이 남는다
allowed_fails와 cooldown_time은 그룹에 정상 배포가 남아 있을 때 효과가 드러난다. 고장난 배포가 allowed_fails를 넘겨 실패하면 cooldown_time 동안 후보에서 빠지고, 재시도가 정상 배포로 넘어가 앱은 200을 받는다. 배포가 하나뿐이거나 전부 죽은 경우엔 그룹이 비지 않도록 쿨다운을 걸지 않는다.
Warning
💡 timeout 검증시 값을 1로 낮췄다가 확인 후 원래 값으로 되돌린다
폴백
폴백은 요청한 배포가 죽어도 대체 배포로 넘겨 앱이 장애를 모른 채 응답을 받게 하는 안전망이다. 먼저 1단 폴백을 실측하고 체인으로 늘린다.
-
llama-small의 api_base를 존재하지 않는 포트(11435)로 바꿔서 백엔드 장애를 만들고 게이트웨이를 재시작한다
-
고장난 llama-small로 요청해도 폴백 덕분에 200 응답이 온다. 응답 헤더를 보면 실제로는 qwen이 처리했음을 확인할 수 있다
curl -s -D - http://localhost:4000/v1/chat/completions \ -H "Authorization: Bearer sk-dotoryeee-1234" \ -H "Content-Type: application/json" \ -d '{"model":"llama-small","messages":[{"role":"user","content":"hi"}],"max_tokens":30}' | grep x-litellm x-litellm-model-name: ollama/qwen2.5:0.5b x-litellm-model-api-base: http://ollama:11434 x-litellm-model-group: qwen-small -
앱은 장애를 전혀 모른 채 응답을 받는다. 확인 후 api_base를 11434로 되돌린다
Notice
💡 폴백 검증시 응답 본문의 model 필드는 요청한 별칭을 그대로 보여주니 반드시 x-litellm 헤더로 확인한다
폴백 체인
후보를 순서대로 이어 1단 폴백을 체인으로 늘릴 수 있다.
-
primary가 죽으면 backup, 그다음 standby로 넘어가는 2단 체인을 정의한다. 검증을 위해 primary와 backup은 열려있지 않은 포트로 두고 standby만 정상 백엔드에 붙인다
litellm_config.yamlmodel_list: - model_name: primary litellm_params: model: ollama/llama3.2:1b api_base: http://ollama:11435 # 고장 - model_name: backup litellm_params: model: ollama/llama3.2:1b api_base: http://ollama:11436 # 고장 - model_name: standby litellm_params: model: ollama/qwen2.5:0.5b api_base: http://ollama:11434 # 정상 router_settings: num_retries: 2 fallbacks: - primary: ["backup", "standby"] # primary → backup → standby -
primary로 요청해도 200이 돌아온다. 헤더를 보면 primary와 backup을 건너뛰고 standby가 처리했다
curl -s -D - -o /dev/null http://localhost:4000/v1/chat/completions \ -H "Authorization: Bearer sk-dotoryeee-1234" -H "Content-Type: application/json" \ -d '{"model":"primary","messages":[{"role":"user","content":"Reply with OK."}],"max_tokens":10}' \ | grep x-litellm-model x-litellm-model-name: ollama/qwen2.5:0.5b x-litellm-model-api-base: http://ollama:11434 x-litellm-model-group: standby -
컨테이너 로그에는 backup까지 재시도하고 실패한 뒤 체인을 넘어간 흔적이 남는다
-
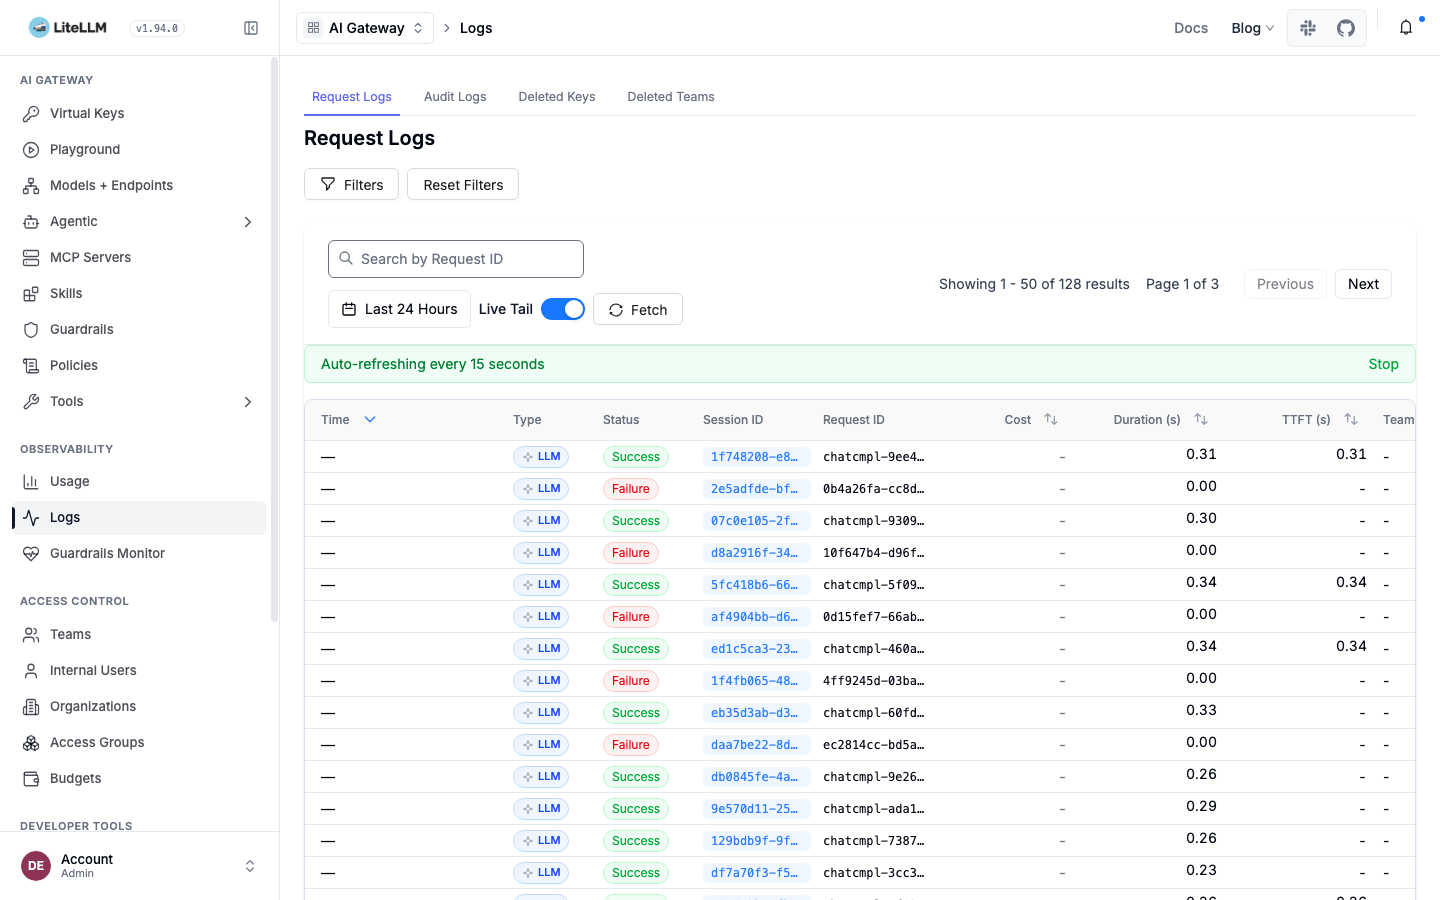
Admin UI의 Logs 메뉴에는 고장난 배포로 향한 요청이 Failure로, 폴백이 넘겨받은 요청이 Success로 나란히 남는다
컨텍스트 초과 같은 비일시적 오류는 재시도가 무의미하므로 별도 경로로 폴백한다. 아래는 실측이 아니라 설정 예시다. 프롬프트가 모델의 컨텍스트 윈도우를 넘으면 context_window_fallbacks에 지정한 더 큰 모델로 곧장 넘긴다.
router_settings:
  context_window_fallbacks:
    - chat-small: ["chat-large"]       # 컨텍스트 초과 시 더 큰 모델로 (설정 예시)
  content_policy_fallbacks:
    - chat-small: ["chat-alt"]         # 콘텐츠 정책 차단 시 타 모델로 (설정 예시)
캐싱
Redis는 이미 compose에 올라와 있으니 게이트웨이 설정에 캐시만 켜면 된다.
-
litellm_config.yaml의 litellm_settings에 캐시 설정을 붙인다. type을 redis로 두고 컨테이너 이름을 host로 지정한다
-
게이트웨이를 재시작한 뒤 캐시 상태를 확인한다. cache/ping이 연결과 set 테스트까지 함께 알려준다
캐시 히트 실측
-
temperature를 0으로 고정한 동일 요청을 두 번 보낸다. 응답 시간과 x-litellm-cache-key 헤더로 히트를 판별한다
REQ='{"model":"qwen-small","messages":[{"role":"user", "content":"Name three primary colors. One line."}],"max_tokens":30,"temperature":0}' # 1회차 (miss) curl -s -o /dev/null -w '%{time_total}s\n' -D - ... -d "$REQ" | grep -i x-litellm-cache 1.452753s (헤더 없음) # 2회차 (hit) curl -s -o /dev/null -w '%{time_total}s\n' -D - ... -d "$REQ" | grep -i x-litellm-cache 0.003956s x-litellm-cache-key: 7640381168783f084d22e742fa267edf54c42976... -
1회차는 백엔드 추론이라 1.45초가 걸렸고, 2회차는 0.004초에 끝났다. 두 응답의 completion id가 chatcmpl-a527692f로 같아서 새로 생성하지 않고 저장된 응답을 그대로 내려보낸 것을 알 수 있다
Notice
💡 캐시 히트 여부는 응답 본문의 model 값이 아니라 x-litellm-cache-key 헤더로 확인한다
시맨틱 캐시
지금까지의 redis 캐시는 요청을 해시로 비교하는 완전 일치 방식이라 프롬프트가 한 글자만 달라도 miss가 된다. 시맨틱 캐시(Semantic Cache)는 프롬프트를 임베딩으로 바꿔 유사도가 임계값 이상이면 히트로 처리한다. 실측에는 임베딩 모델이 필요해 아래는 실행 결과가 아니라 설정 예시다.
litellm_settings:
  cache: true
  cache_params:
    type: redis-semantic                          # 완전 일치 대신 의미 유사도로 매칭
    similarity_threshold: 0.8                      # 0.8 이상이면 히트로 간주 (설정 예시)
    redis_semantic_cache_embedding_model: my-embed # model_list에 등록된 임베딩 모델
임계값이 낮을수록 더 느슨하게 히트해 절감폭은 커지지만 엉뚱한 답을 재사용할 위험도 함께 올라간다. "리스트를 정렬하는 법"과 "파이썬에서 리스트 정렬"처럼 표현만 다른 질문을 한 답으로 묶고 싶을 때 쓴다.
캐시 운영 주의점
- TTL은 cache_params에 ttl로 초 단위 만료를 걸고, 요청별로 cache의 ttl이나 s-maxage로 덮어쓸 수 있음. 기본은 만료가 없어 값이 바뀌지 않는 질문에만 오래 두는 것이 안전
- supported_call_types로 캐시를 적용할 엔드포인트를 좁힐 수 있음. 기본은 completion과 embedding을 포함한 전 유형이 켜져 있음
- 스트리밍 응답도 캐시돼 히트 시 저장된 내용을 청크로 재생하므로 앱 코드는 스트리밍인지 캐시인지 구분하지 않아도 됨
Warning
💡 사용자·시간에 따라 답이 달라지는 요청은 캐시하면 오답을 재사용하니 TTL을 짧게 둔다
비용 추적과 예산
Ollama 백엔드는 LiteLLM 기본 단가가 0이라 아무리 호출해도 spend가 쌓이지 않는다. 유료 API의 비용 추적을 흉내내려면 model_list의 litellm_params에 토큰당 단가를 직접 넣는다.
-
두 모델에 입력·출력 단가를 지정한다. 데모용 값이고 실제 요금과는 무관하다
-
마스터 키로 추적용 virtual key를 발급한다. spend가 0.0에서 시작한다
-
이 키로 서로 다른 프롬프트를 여러 번 호출하고 key/info로 누적 spend를 확인한다. spend 반영은 비동기라 몇 초 뒤 값이 확정된다
지정한 단가대로 토큰 사용량이 달러로 환산돼 키에 쌓였다. 단가를 넣지 않았다면 같은 호출에도 spend는 계속 0이었을 것이다.
캐시 히트와 비용
-
같은 키로 새 요청을 한 번(miss) 보내고 곧바로 동일 요청을 한 번 더(hit) 보낸 뒤 spend 변화를 본다
-
두 번 호출했는데 spend는 miss 한 건 값인 약 3.8e-5만 늘고 hit는 0을 더했다. 캐시는 지연을 줄이는 동시에 같은 요청의 토큰 비용을 없앤다
예산 초과 차단
-
max_budget을 아주 작게 건 키를 발급한다. 한 호출 비용보다 조금 큰 0.0001달러로 둔다
-
이 키로 호출을 반복하면 누적 spend가 예산을 넘는 순간 차단된다. 응답 코드는 400이 아니라 429이고 type이 budget_exceeded다
-
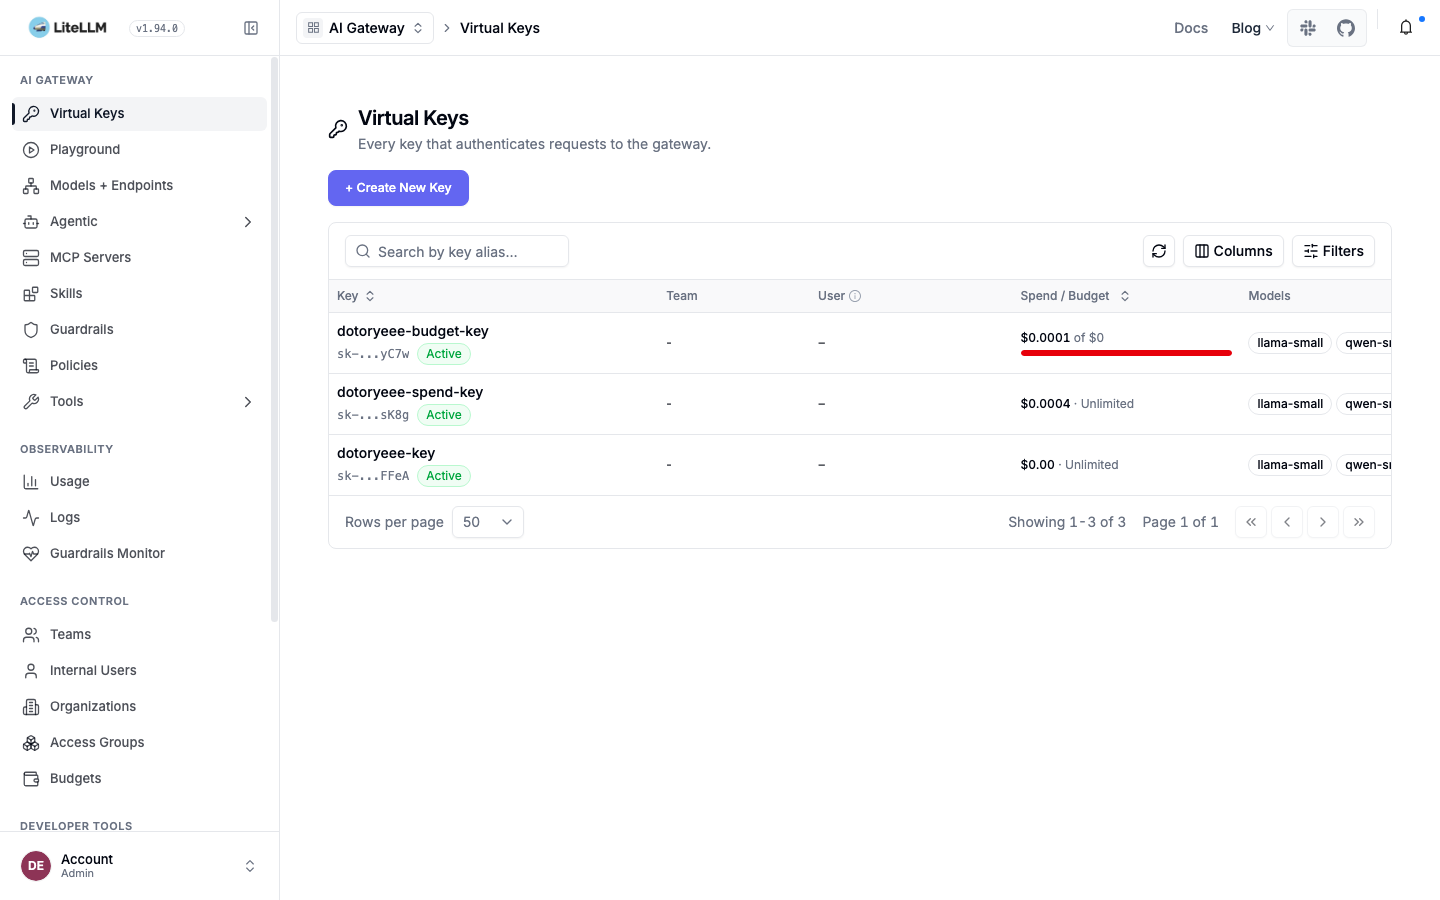
Admin UI의 Virtual Keys 메뉴에서 dotoryeee-budget-key의 예산 소진 막대와 dotoryeee-spend-key의 누적 Spend를 함께 확인할 수 있다
Warning
💡 spend 반영이 비동기라 예산 직전 한두 건은 통과한 뒤 차단된다
관측성
관측성(Observability)이란 게이트웨이를 지나는 요청의 내부 상태를 로그·메트릭·트레이스로 밖에서 파악 가능하게 만드는 성질
LLM 관측이 다른 이유
일반 백엔드 지표에 토큰·비용·첫 토큰 지연 차원이 더해지는 것이 LLM 관측의 특징
| 관측 차원 | 일반 API 백엔드 | LLM 백엔드 |
|---|---|---|
| 지연 | 요청~응답 시간 | 요청~응답 + TTFT(첫 토큰까지) 분리 |
| 처리량 | 초당 요청 수(RPS) | RPS + 초당 토큰 수 |
| 비용 | 인프라 고정비 | 요청마다 토큰 종량 과금 |
| 실패 | 4xx/5xx | 4xx/5xx + 폴백·재시도 발생 |
- 스트리밍 응답은 전체 지연 하나로 못 봄 → 첫 토큰(TTFT)과 완료 시간을 분리 측정
- 비용이 요청마다 달라지고 폴백·재시도가 정상 경로에 섞임 → 토큰·spend와 실제 처리 백엔드를 요청 단위로 기록 필요
요청 단위 관측: 응답 헤더
응답 헤더 한 벌이 요청별 지연 분해와 라우팅 결과를 그대로 실음
curl -s -D - -o /dev/null http://localhost:4000/v1/chat/completions \
  -H "Authorization: Bearer sk-dotoryeee-1234" -H "Content-Type: application/json" \
  -d '{"model":"qwen-small","messages":[{"role":"user","content":"hi"}],"max_tokens":10}'

x-litellm-call-id: 4fca4ae9-2075-4c3f-8b74-8655cccb42dd
x-litellm-response-duration-ms: 395.33
x-litellm-overhead-duration-ms: 6.84
x-litellm-model-group: qwen-small
x-litellm-attempted-retries: 0
x-litellm-attempted-fallbacks: 0
| 헤더 | 의미 |
|---|---|
x-litellm-call-id |
요청 추적용 고유 ID, 로그·트레이스 상관에 사용 |
x-litellm-response-duration-ms |
백엔드 응답까지 총 소요 시간 |
x-litellm-overhead-duration-ms |
게이트웨이 자체 처리로 더해진 시간 |
x-litellm-attempted-retries |
이 응답이 나오기까지 재시도 횟수 |
x-litellm-attempted-fallbacks |
폴백 발생 횟수, 0 초과면 대체 백엔드가 처리 |
- response-duration과 overhead-duration이 분리돼 지연 원인이 백엔드인지 게이트웨이인지 구분 가능
- attempted-fallbacks가 0보다 크면 요청한 별칭이 아닌 대체 백엔드가 응답 (폴백이 발생했다는 신호)
- 키 단위 누적 spend는
/key/info, 요청 단위 감사 로그는/spend/logs로 조회
{"request_id":"chatcmpl-db7a1fa7-ea4f-4b80-8a53-21b3f5bae931","call_type":"acompletion",
 "model":"ollama/llama3.2:1b","total_tokens":124,"spend":0.0,"cache_hit":null}
TTFT 실측
TTFT(Time To First Token)이란 요청 전송부터 첫 토큰이 도착하기까지의 시간으로, 스트리밍 체감 속도를 좌우하는 지표
- 전체 지연은 마지막 토큰까지, TTFT는 첫 토큰까지 → 사용자 체감은 TTFT가 결정
- curl -w의 time_starttransfer(첫 바이트)와 time_total(완료)로 분해 측정
WFMT='TTFB=%{time_starttransfer}s  total=%{time_total}s\n'

# 논스트리밍 (stream:false)
TTFB=2.785s  total=2.785s

# 스트리밍 (stream:true)
TTFB=0.208s  total=4.009s
- 논스트리밍은 TTFB와 total이 사실상 같음 → 전체 생성이 끝날 때까지 클라이언트가 대기
- 스트리밍은 첫 바이트가 0.2초, 완료가 약 4초 → 첫 토큰을 먼저 흘려보내 체감 지연을 줄임
- 프로메테우스
litellm_llm_api_time_to_first_token_metric도 스트리밍 호출에서만 기록됨 (같은 요청 sum=0.181)
메트릭: Prometheus
callbacks에 prometheus 한 줄로 /metrics 엔드포인트가 열리고 요청·지연·토큰·비용이 시계열로 쌓임
litellm_settings:
  drop_params: true
  callbacks: ["prometheus"]     # /metrics 엔드포인트 노출
curl -sL http://localhost:4000/metrics -H "Authorization: Bearer sk-dotoryeee-1234"

litellm_proxy_total_requests_metric_total{requested_model="qwen-small",status_code="200",...} 3.0
litellm_request_total_latency_metric_bucket{le="0.5",model="qwen2.5:0.5b",...} 3.0
litellm_llm_api_time_to_first_token_metric_sum{model="qwen2.5:0.5b",...} 0.181239
litellm_overhead_latency_metric_sum{model_group="qwen-small",...} 0.003282
litellm_deployment_success_responses_total{model_group="qwen-small",...} 3.0
프로메테우스를 랩 네트워크에 붙여 /metrics를 주기적으로 스크레이프. 마스터 키를 Bearer 토큰으로 실어 인증
global:
  scrape_interval: 5s

scrape_configs:
  - job_name: litellm
    metrics_path: /metrics
    authorization:
      type: Bearer
      credentials: sk-dotoryeee-1234    # LiteLLM 마스터 키
    static_configs:
      - targets: ["litellm:4000"]       # compose 서비스 이름
스크레이프 후 표현식 브라우저 Table 뷰에서 litellm_proxy_total_requests_metric_total 조회 → requested_model·status_code·api_key_alias 라벨별 요청 수 집계
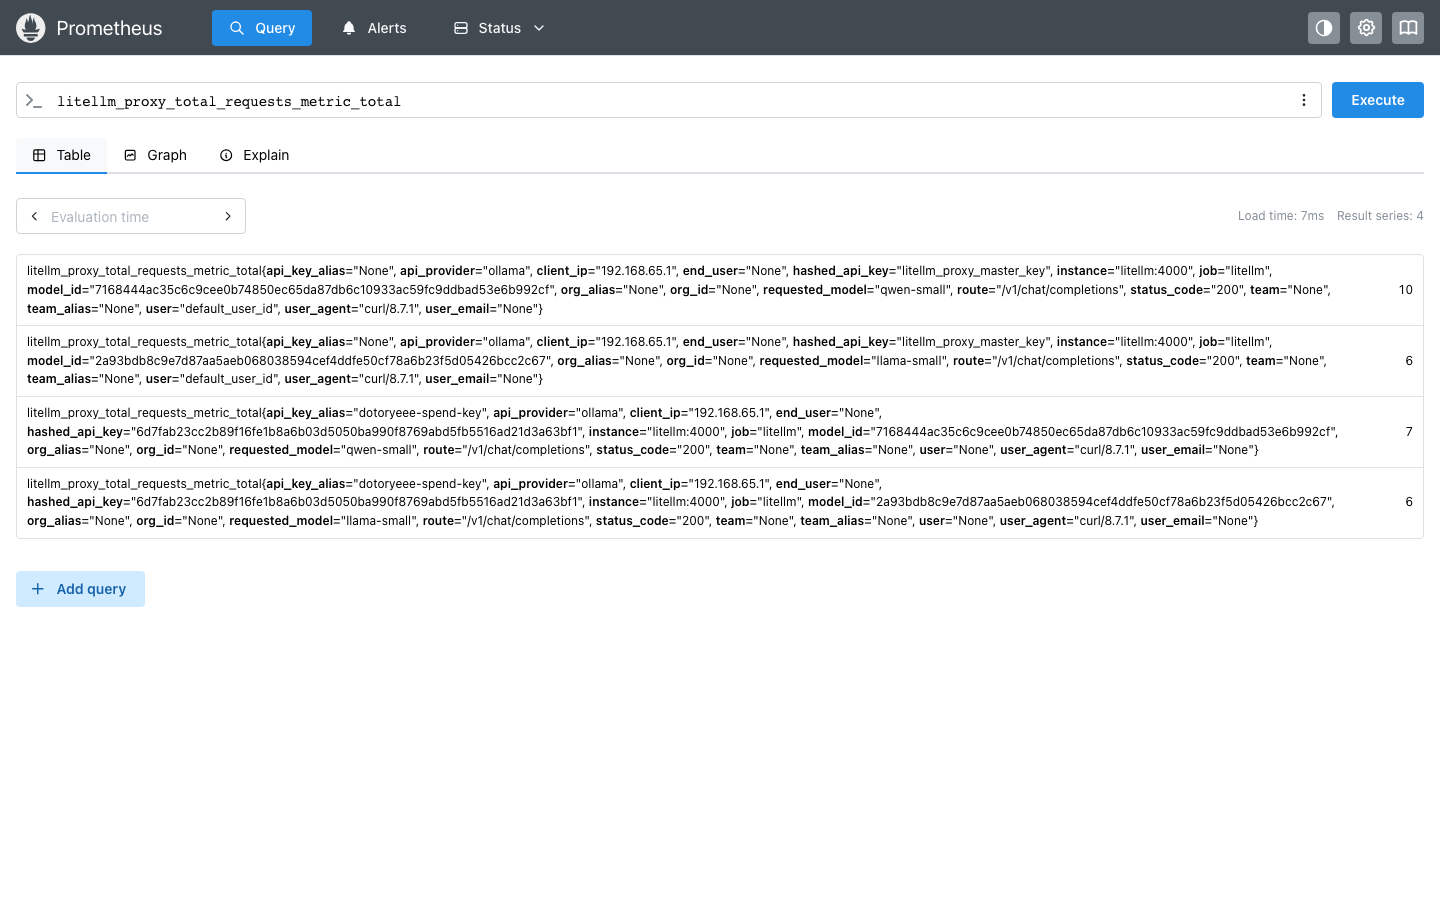
dotoryeee-spend-key로 보낸 호출이 별도 시계열로 잡혀 키 별칭 단위 사용량 추적 가능
| 메트릭 | 관측 대상 |
|---|---|
litellm_request_total_latency_metric |
요청 전체 지연 히스토그램 |
litellm_llm_api_time_to_first_token_metric |
TTFT 히스토그램(스트리밍) |
litellm_overhead_latency_metric |
게이트웨이 자체 오버헤드 |
litellm_spend_metric / litellm_total_tokens_metric |
비용·토큰 누적 |
litellm_deployment_success/failure_responses_total |
백엔드별 성공·실패 수 |
litellm_deployment_successful_fallbacks_total |
폴백 발생 횟수 |
- 이 랩은 LiteLLM 1.94.0 community이며
has_license:false상태에서/metrics가 그대로 동작 → 프로메테우스 메트릭은 무료 코어에 포함 - Enterprise 티어가 더하는 것은 SSO·RBAC·감사 로그 같은 거버넌스 기능이지 기본 메트릭·트레이싱이 아님 (community/Enterprise 라이선스 경계와 동일)
- 다만 프로메테우스 통합의 무료·유료 경계는 버전마다 달라진 이력 → 배포 버전에서 직접 확인 권장
트레이싱: OpenTelemetry
OpenTelemetry(OTEL)는 요청 하나를 내부 단계별 span으로 쪼개 어느 구간에서 시간이 샜는지 추적하는 표준
    environment:
      OTEL_EXPORTER: otlp_http
      OTEL_ENDPOINT: http://otel-collector:4318 # 수집기 주소
otel-collector를 debug exporter로 띄우고 요청 한 건을 보내면 하나의 trace_id 아래 내부 span이 도착함
service.name: litellm
Trace ID: c69af1f904d85841782a2f8bb8d585c2
  auth                # 키 인증
  postgres            # 사용자 조회
  proxy_pre_call      # pre-call 훅
  router              # 배포 선택
  litellm_request
  raw_gen_ai_request  # 실제 백엔드 LLM 호출
  batch_write_to_db   # spend 비동기 기록
- 한 요청 = 한 trace_id, 인증·라우팅·백엔드 호출이 각각 span → 지연이 게이트웨이 내부인지 백엔드인지 분리
- OTEL도 community 무료. 같은 OTLP로 Jaeger·Tempo·Datadog 등 백엔드에 그대로 전송
- 프롬프트·응답 본문까지 보는 LLM 특화 관측은
callbacks: ["langfuse"]+ LANGFUSE_* 환경변수로 교체 (설정 예시)
무엇에 알람을 거는가
관측의 목적은 대시보드가 아니라 개입 시점을 잡는 것 → 아래 네 축을 우선 알람화
| 축 | 메트릭 | 알람 신호 |
|---|---|---|
| 오류율 | litellm_proxy_failed_requests_metric |
5xx 비율이 기준선 초과 |
| 폴백 발생 | litellm_deployment_successful_fallbacks_total |
증가 시 주 프로바이더 장애 조기 신호 |
| 예산 소진 | litellm_remaining_api_key_budget_metric |
키별 잔여 예산이 임계 이하 |
| TTFT 악화 | litellm_llm_api_time_to_first_token_metric |
p95 TTFT가 기준 초과 |
- 게이트웨이 자체 병목은
litellm_overhead_latency_metric급증으로 잡음 → 백엔드가 멀쩡한데 지연이 늘면 게이트웨이 의심 - 폴백은 200으로 응답되는 "성공한 장애"라 지표를 안 보면 놓침 → 폴백 카운터를 반드시 알람에 포함
Admin UI 확인
-
http://localhost:4000/ui 에 접속해 dotoryeee 계정(비밀번호는 마스터 키)으로 로그인한다
-
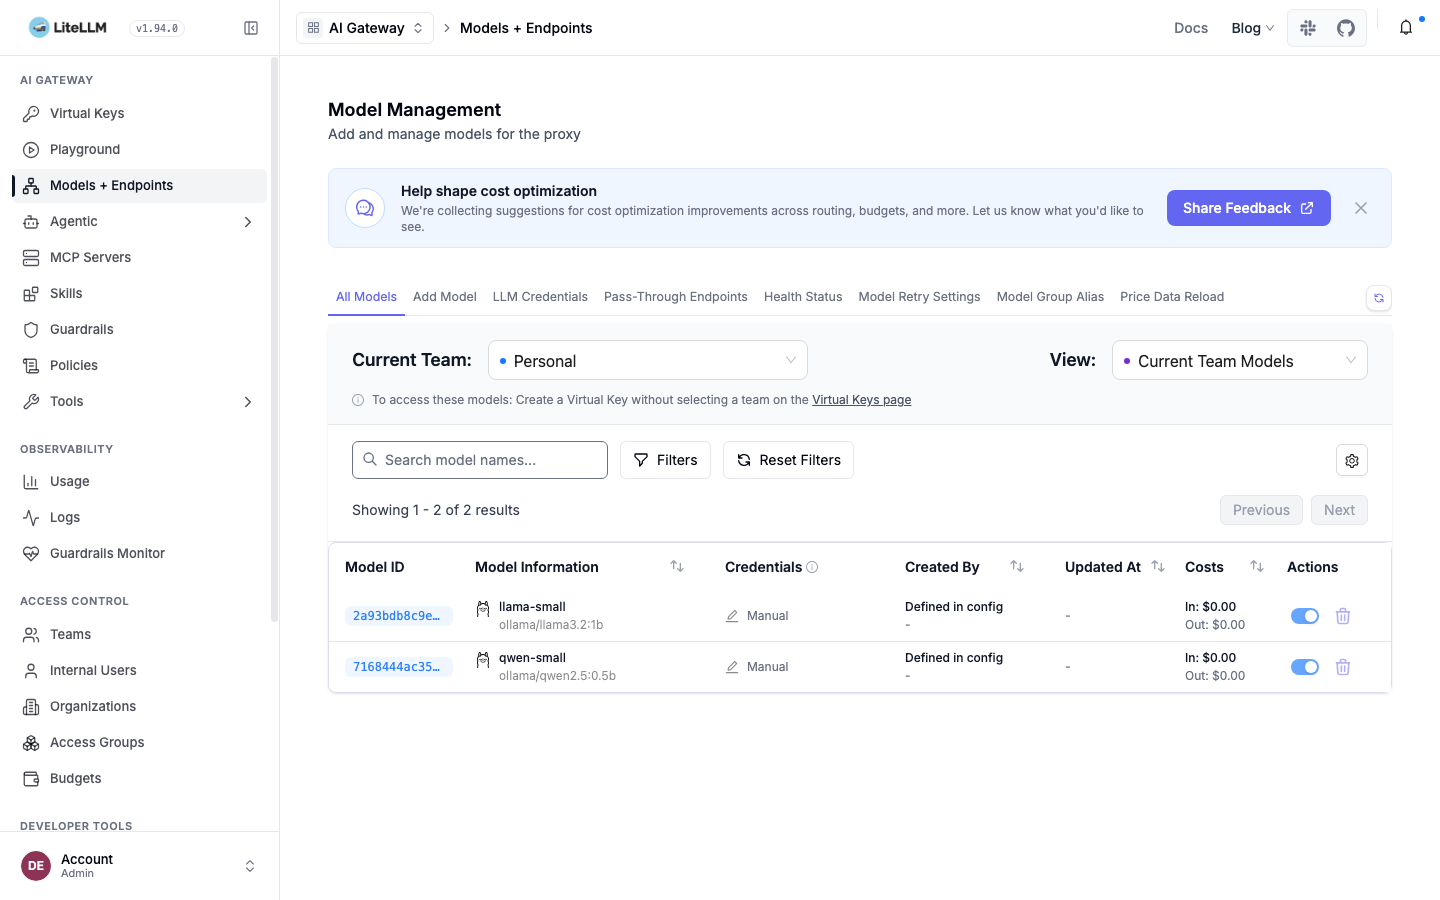
Models 메뉴에 등록한 모델이 올라와 있다
-
Virtual Keys 메뉴에는 발급한 키의 사용량과 예산이 표시된다
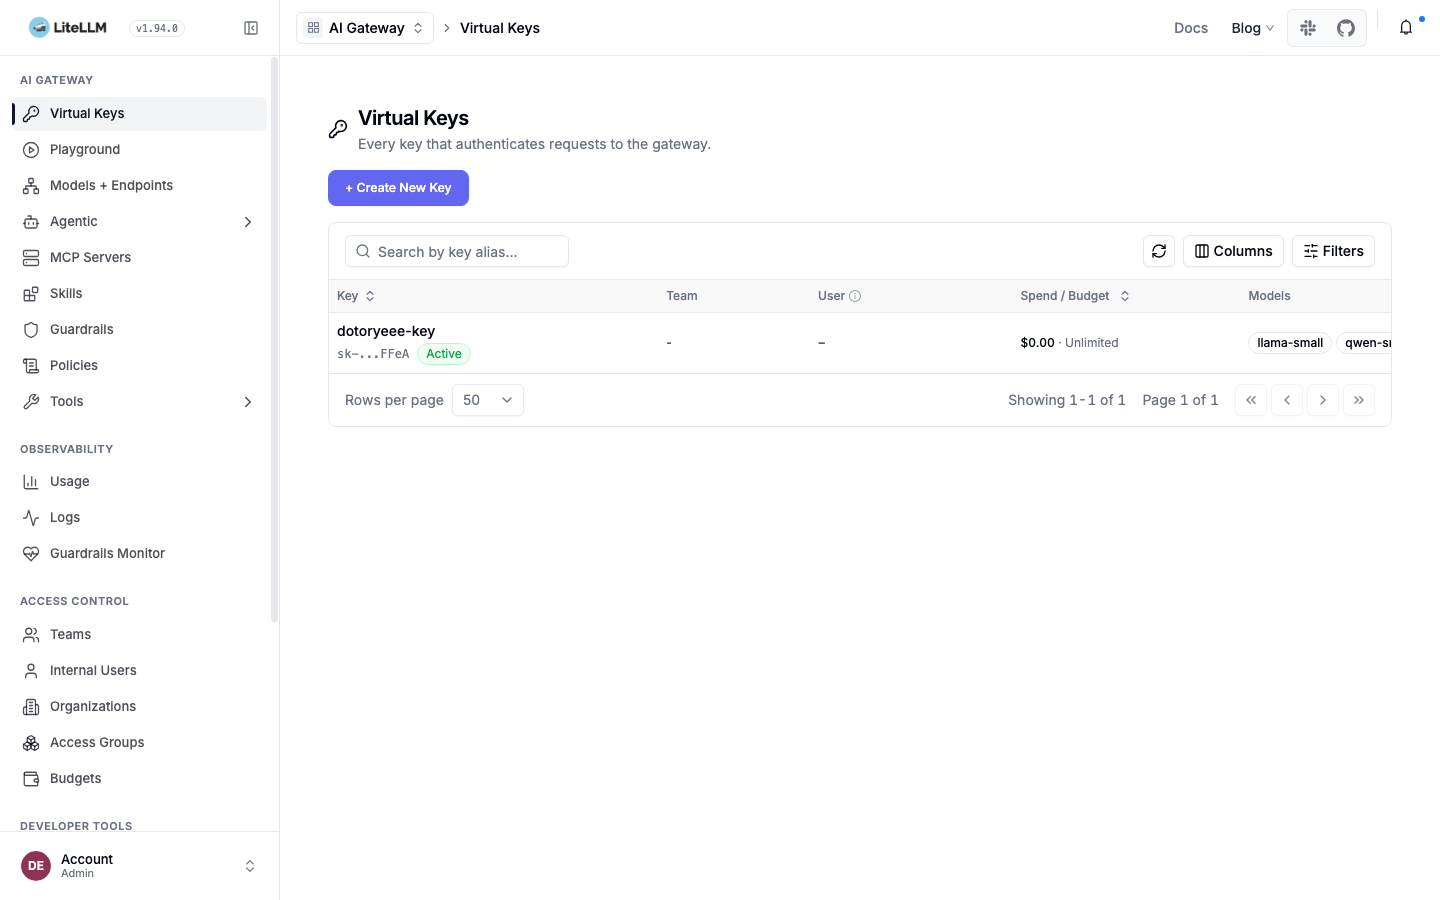
dotoryeee-key 키가 발급되어 있고 Spend 추적이 동작한다
-
Logs 메뉴에서 요청별 처리 결과와 소요 시간을 추적할 수 있다
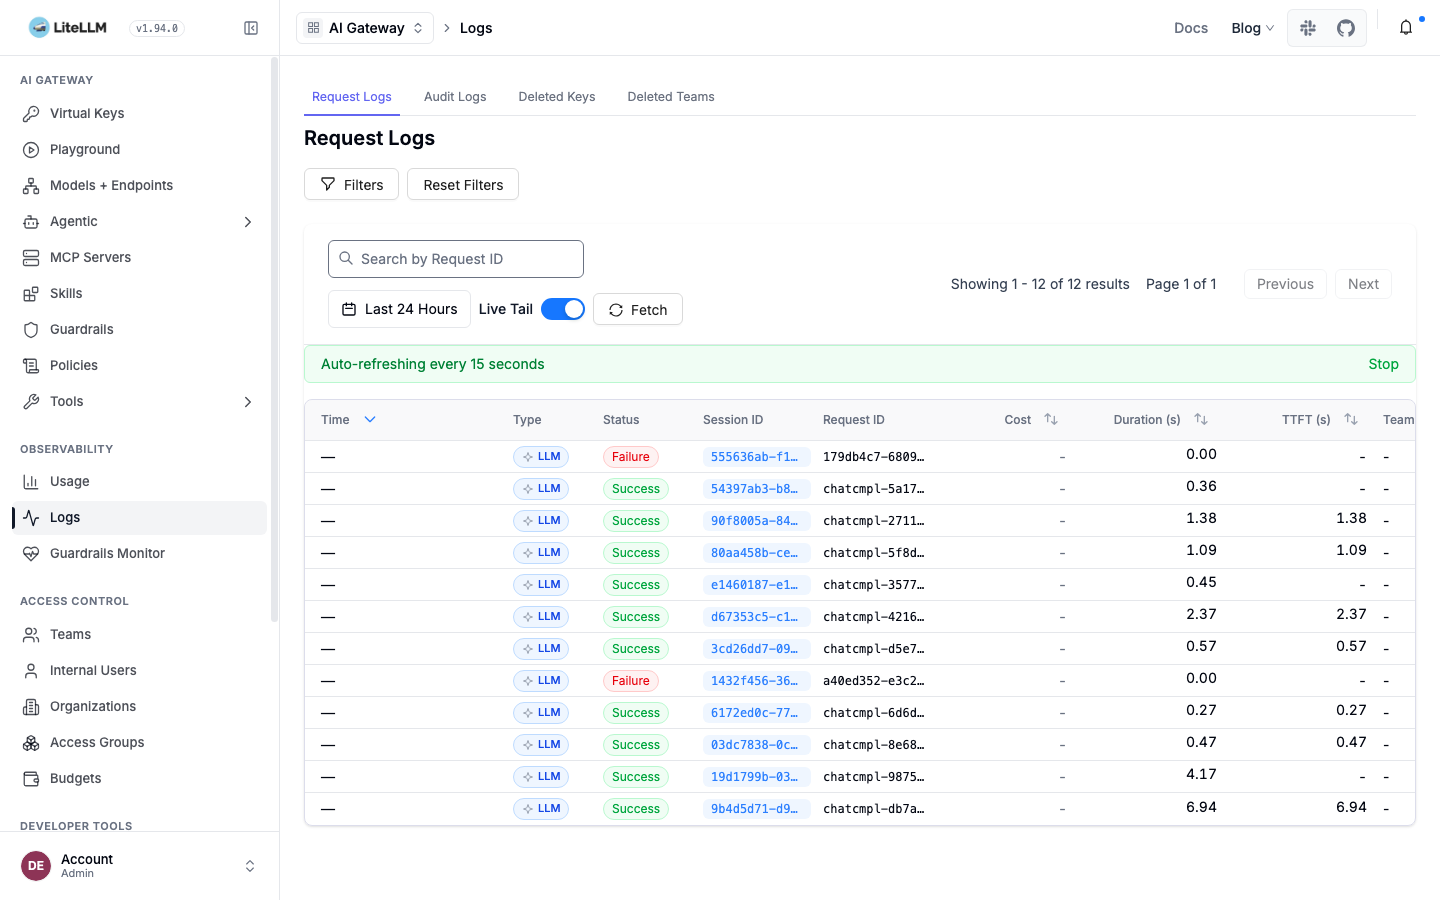
폴백 실습에서 발생시킨 Failure 기록까지 그대로 남아있다
결론
토큰 단위 통제 원리와 LiteLLM·Kong·Portkey·Cloudflare·Envoy 비교, 가드레일 설계는 AI Gateway 정리에서 다뤘다.
- 게이트웨이 하나로 통합 API, 키 관리, rate limit, 로드밸런싱, 폴백, 캐시, 비용 추적, 관측이 전부 한 스택에서 동작함을 확인했다
- 백엔드를 Ollama에서 OpenAI/Bedrock으로 바꿔도 model_list에 항목만 추가하면 되고 당연히 앱 코드는 그대로다
- 배포가 모두 정상일 때는 weight와 routing_strategy가 트래픽을 고르게 나누고, 배포가 순차로 죽어도 num_retries, timeout, 폴백 체인이 마지막 정상 후보까지 요청을 이어준다
- redis 캐시는 같은 요청의 두 번째 호출을 1.45초에서 0.004초로 줄이고 토큰 비용을 0으로 만들며, max_budget은 429 budget_exceeded로 예산을 강제한다
- 응답 헤더·프로메테우스·OTEL 세 층위로 관측이 완성되고, 알람은 오류율·폴백·예산·TTFT 네 축이면 대부분의 사고를 조기에 포착한다
- 게이트웨이를 세우는 일이 "한 곳으로 모으기"였다면, 운영은 "그 안을 밖에서 들여다보며 끊기지 않게 지키기"